
昨天我們用向量的角度理解一遍 Self-Attention。今天,我們用一個模擬的方式,來試著再理解一次。(這個例子我想好久,不完美但可能有點 fu)
想像桌上有一幅未完成的拼圖,我們的任務是:搞清楚拼圖間的關聯,把當前拼圖碎片拼進正確位置,推測下一塊該接什麼。
桌上剛從盒子裡倒出三塊拼圖碎片(現實生活當然是很多片):
「頭髮部分」(頂部碎片)「眼睛部分」(上方核心碎片)「鼻子部分」(當前主角碎片)在還沒開始拼之前,它們只是帶著自身色彩的木片(原始輸入向量 x)。如果不理解相鄰關係,誰也不知道拼圖本身的意義,應該拼在哪裡。
每一塊碎片進入拼接時,都可以拆解出三個維度的資訊:
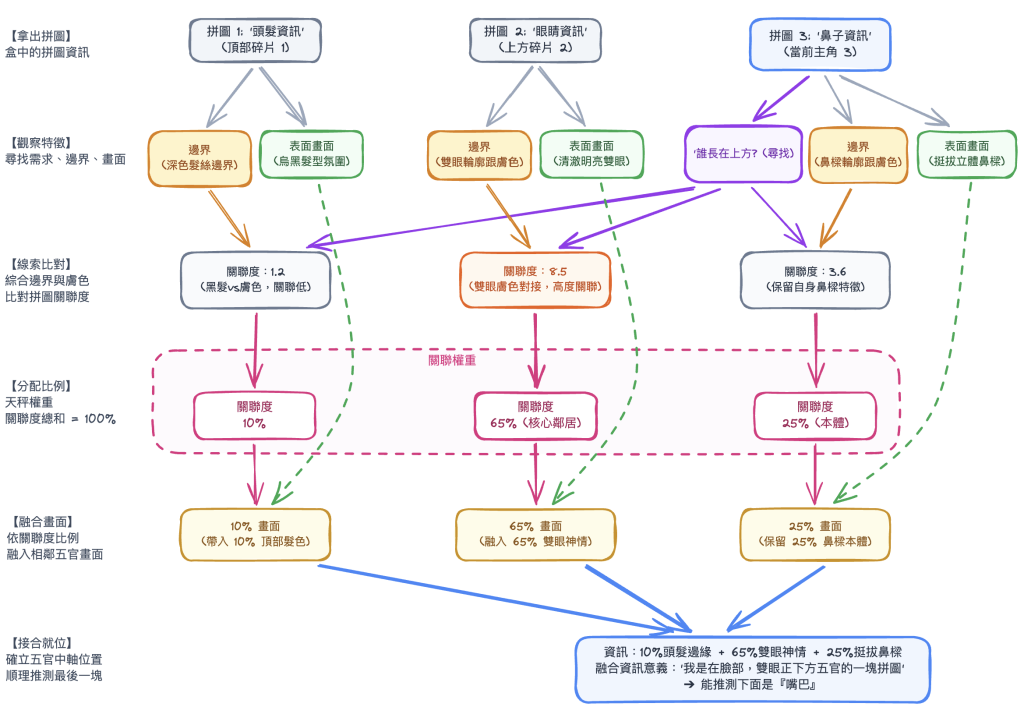
我們現在一樣把主角聚焦在 「鼻子部分的拼圖」 身上(紫色),拼接過程會像是這樣:
拼拼圖絕對不是盲目硬比對卡榫,而是觀察顏色、紋理與空間位置:
這是一場由上而下的拼圖遊戲。在拼「鼻子」這一刻:臉部下方的「嘴巴」碎片還留在盒子裡,不能拿出來看。(這不合理,稍微接受一下哈哈 XDD)
把各塊碎片的關聯強度換算成你想參考的權重,算出一組總和為 100% 的比例:
拿著算好的關聯比例,把大家的表面畫面(V)整合,重新理解對於自己「鼻子」這塊拼圖的資訊:輸出資訊 = 10 * V_1(頂部髮色) + 65 * V_2(雙眼神情) + 25 * V_3(挺拔鼻樑)
這塊全新融合好的「鼻子」拼圖資訊(輸出向量 b_3),獲得了完整的上下文定位:
希望這個例子,有讓你覺得更能想像 Self-Attention,它的目的就是讓每個 Token 帶著需求(Q),在場上比對邊界線索吻合的對象(K),再依關聯度把對方的畫面資訊(V)整合進來,確定自己的全局定位,重新理解自己的定義。
從拼圖的例子中,也能直接引出了大模型推論時很關鍵的工程策略:
當下一輪輪到「嘴巴」登場時,
(1) 頭髮、眼睛、鼻子的邊界(K)與畫面(V)在「嘴巴」比對時,是不是可以重複使用?
(2) 那當初鼻子用來找人的需求(Q),還需要嗎?
可以來想看看這個問題,明天見~


 iThome鐵人賽
 看影片追技術